

DB Lookup 변환 소개
세상의 서비스가 다루는 데이터는 정합성을 유지하기 위해 중복이 없는 데이터 구조를 갖습니다. 이렇게 중복을 없앤 데이터 구조는 저장 공간을 절약할 수 있다는 등 다양한 장점이 있는 반면, 데이터가 수많은 작은 조각으로 나뉘게 된다는 측면도 있습니다. 원래 하나의 데이터 구조에 담겨 있던 내용이 정규화 과정을 거치면서 성격이 다른 여러 데이터로 분리되는 것입니다. 이렇게 분리된 데이터는 공통 키를 이용해 원래 형태로 복원할 수 있습니다. 데이터베이스에서 익숙한 JOIN에 의한 결합이 바로 이 복원 작업에 사용됩니다. Xplenty에서는 지금까지 데이터 간 결합에 JOIN 컴포넌트를 사용해 왔습니다. 데이터베이스나 API에서 가져온 데이터를 공통 키로 연결할 수 있지만, 결합 수가 늘어날수록 데이터 처리 로직이 복잡해져 파악하기 어려워진다는 문제가 있었습니다. 이번에 소개하는 DB Lookup 변환은 JOIN 컴포넌트와 같은 역할을 하면서도 데이터 처리 로직을 훨씬 단순하게 만들어주는 훌륭한 컴포넌트입니다.JOIN 컴포넌트와의 차이
같은 결합을 두 가지 방식으로 구성해 보기
간단한 결합 예시로, 아래와 같은 두 개의 테이블을 하나로 합치는 상황을 생각해 보겠습니다.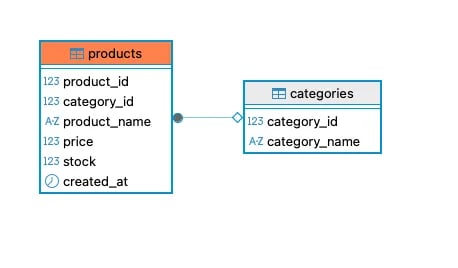
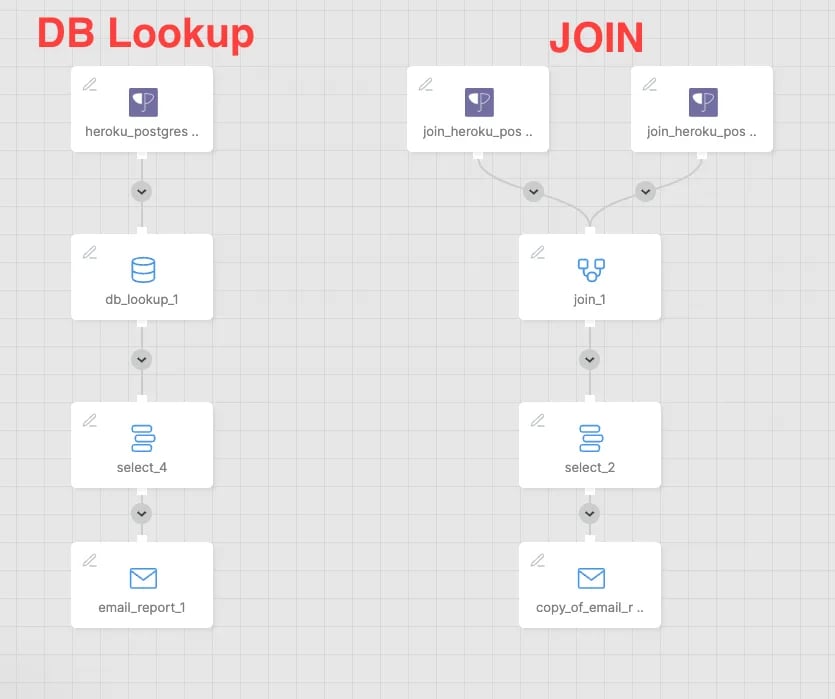
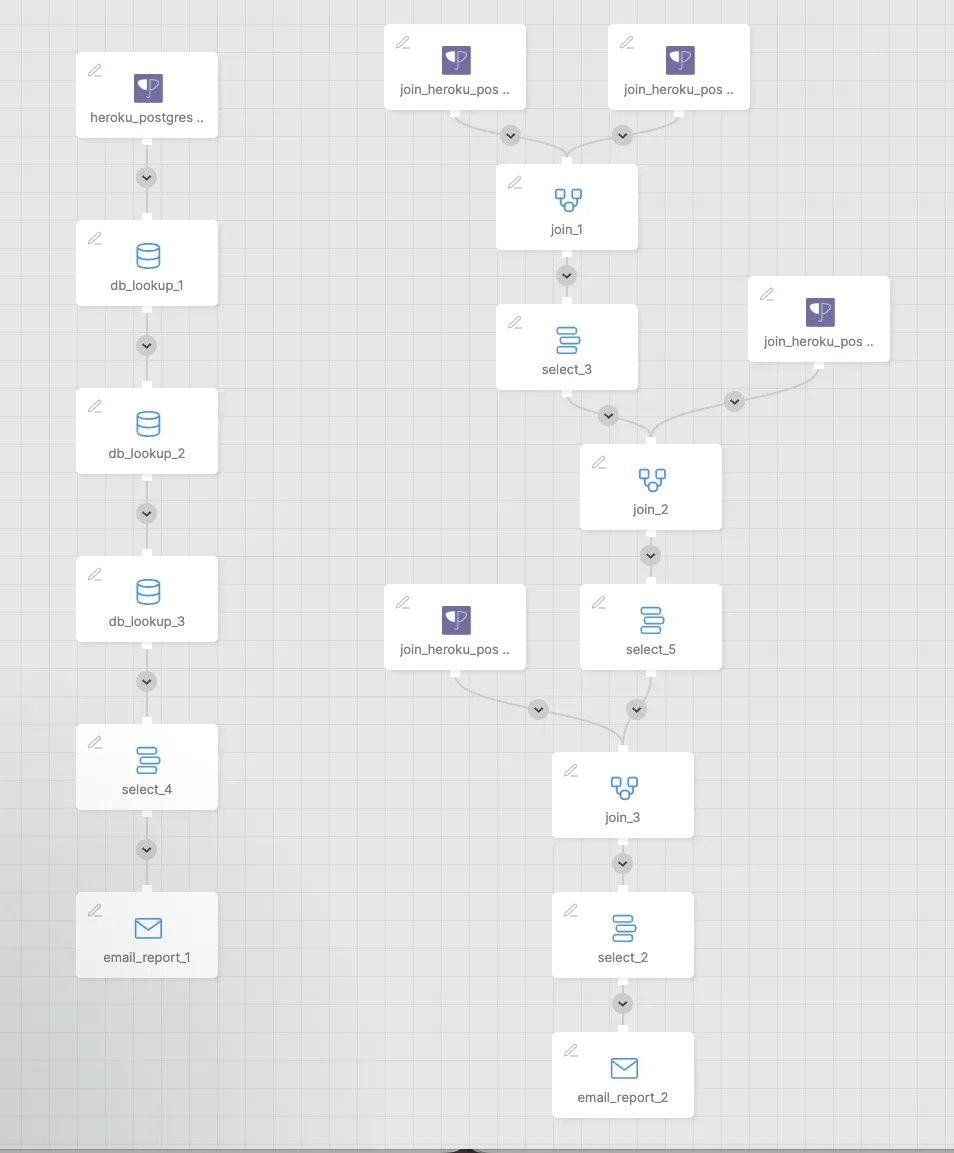
4단계로 설정 완료
DB Lookup 컴포넌트의 설정은 4단계로 구성되어 있습니다. 각 단계별 설정 내용을 참조 테이블(Lookup 대상)의 설정을 중심으로 살펴보겠습니다.단계 1: Lookup 대상 데이터베이스 커넥터 선택(Choose input connection)
Lookup용 데이터를 보유한 데이터베이스 커넥터를 선택합니다. 여기서 선택한 커넥터에서 참조 테이블 또는 쿼리 결과가 읽어집니다.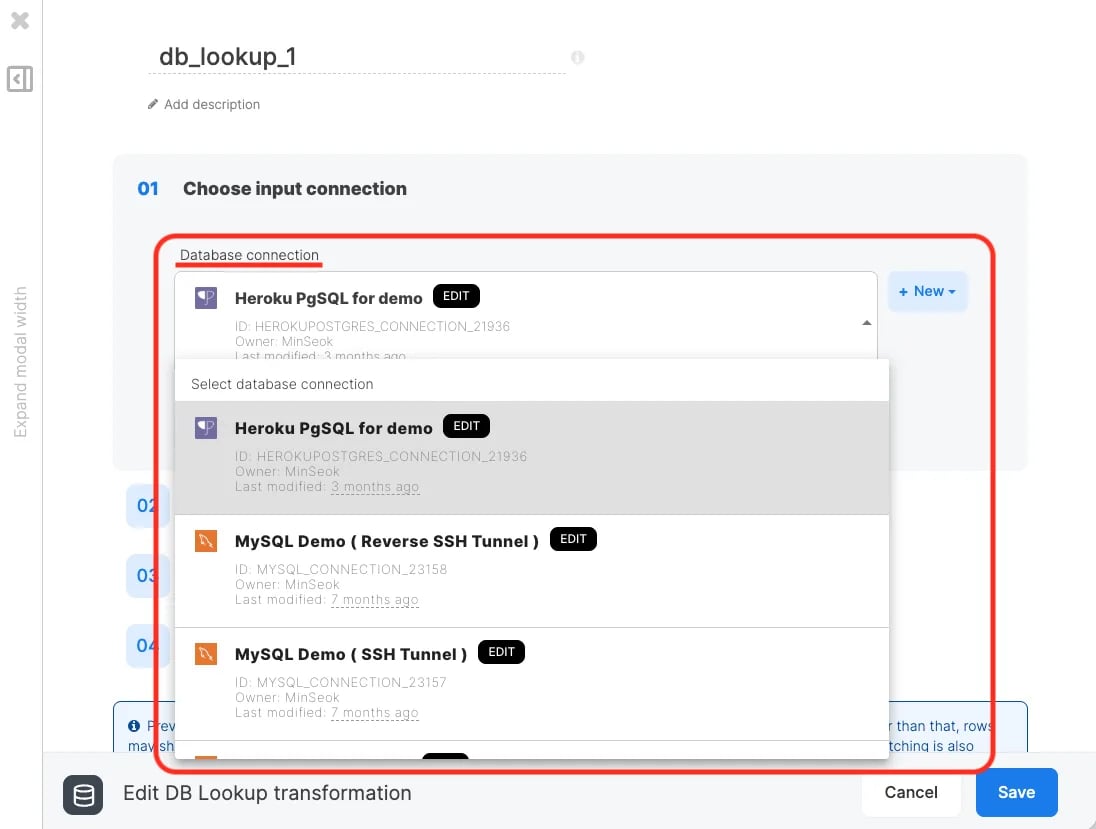
단계 2: 참조 방식과 일치 조건 정의(Lookup properties)
Lookup 대상의 읽기 방식과 키가 일치했을 때/일치하지 않았을 때의 동작을 설정합니다. Lookup source(Lookup 대상)- Table Direct: 단일 테이블을 그대로 읽습니다
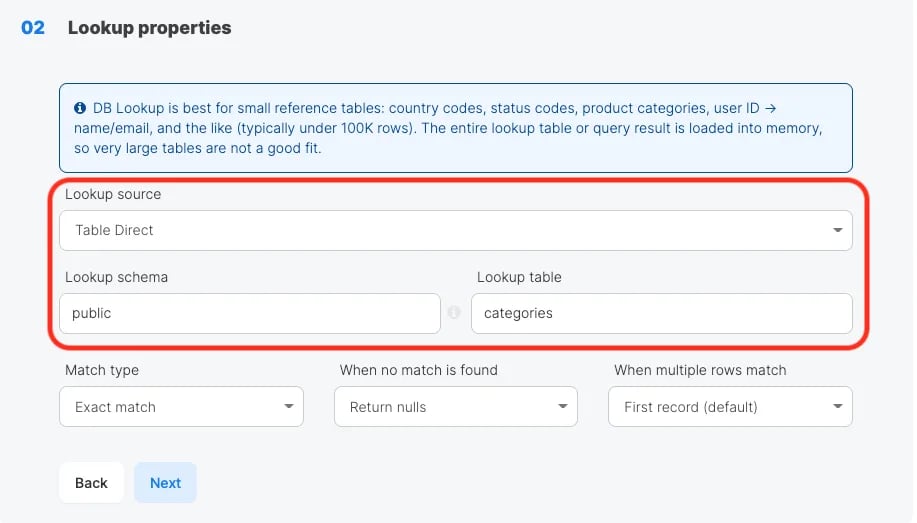
- Lookup schema / Lookup table: 읽어올 대상 스키마와 테이블을 지정합니다
- Custom SQL Query: SQL 쿼리의 실행 결과를 읽습니다
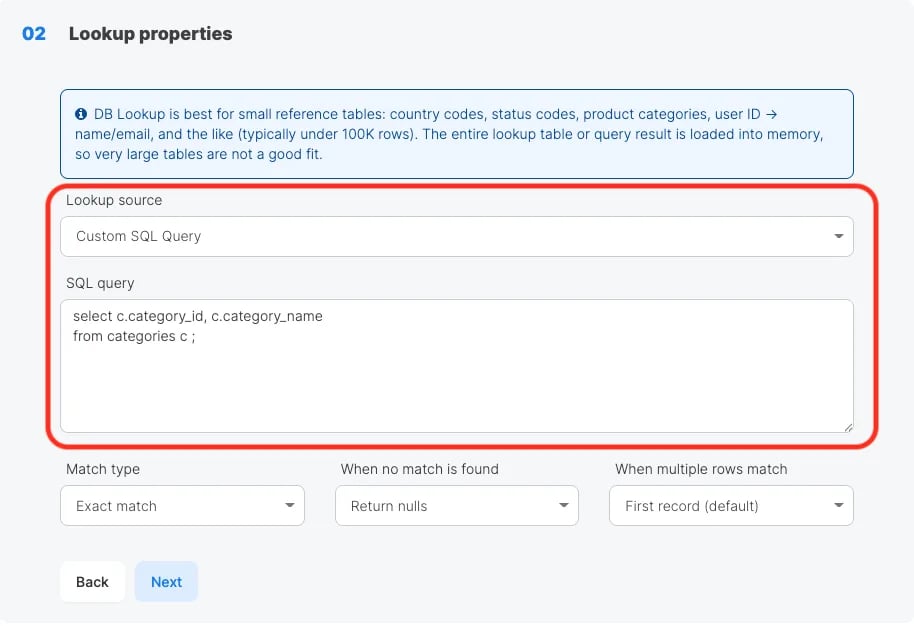
- Query: Lookup 데이터로 사용할 SQL 쿼리를 지정합니다
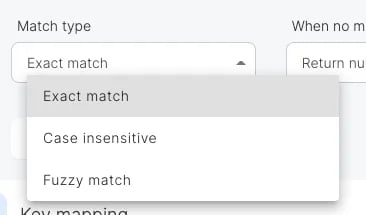
- Exact match: 키를 완전히 일치하는지 비교합니다
- Case insensitive: 텍스트 키의 대소문자를 구분하지 않고 비교합니다
- Fuzzy: 유사도로 점수를 매겨, 임계값 이상 중 가장 점수가 높은 항목을 반환합니다(자세한 내용은 아래 “Fuzzy 매칭에 대하여”를 참고하세요)
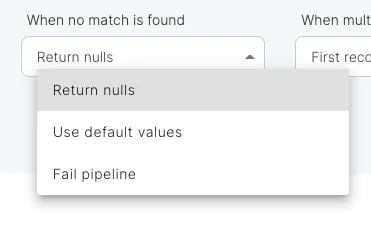
- Return nulls: Lookup 컬럼에 null을 출력합니다
- Use default values: 단계 3에서 설정한 기본값을 출력합니다
- Fail pipeline: 작업을 중단합니다
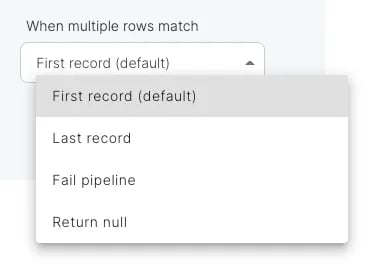
- First record(기본값): 처음 일치한 행을 반환합니다
- Last record: 마지막에 일치한 행을 반환합니다
- Fail pipeline: 작업을 중단합니다
- Return null: null을 반환합니다
Fuzzy 매칭에 대하여
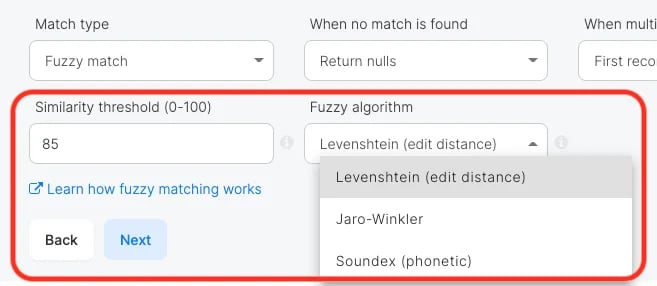
- Similarity threshold(유사도 임계값, 0~100) 일치로 간주할 최소 점수입니다. 기본값은 85이며, 값을 높이면 판정이 엄격해지고 낮추면 느슨해집니다.
-
Fuzzy algorithm(알고리즘)
- Levenshtein(기본값): 문자의 편집 거리로 점수를 매깁니다. 오타나 짧은 철자 차이에 대응하는 데 적합합니다
- Jaro-Winkler: 앞부분의 일치를 높게 평가합니다. 이름이나 약칭 비교에 유용합니다
- Soundex: 발음으로 비교하며 점수는 100 또는 0 중 하나만 반환합니다. Robert / Rupert처럼 발음이 비슷한 이름을 비교하는 데 유용하지만, Soundex에서는 유사도 임계값이 작동하지 않습니다
- 키 매핑은 1개 조합만 지원하며, 복합 키에는 Fuzzy 일치를 사용할 수 없습니다
- 비교는 항상 대소문자를 구분하지 않습니다
- 최고 점수가 여러 행에서 동점일 경우 When multiple rows match 설정을 따릅니다
- 임계값 미만의 점수는 “일치 없음”으로 처리되며 When no match is found 설정이 적용됩니다
- 입력 행마다 Lookup 테이블 전체를 스캔하므로, Fuzzy를 사용할 때는 테이블 크기를 충분히 작게(기준으로 10만 행을 크게 밑도는 규모로) 유지하세요
단계 3: 비교할 키 매핑(Key mapping)
입력 필드와 비교 대상이 되는 Lookup 컬럼을 매핑합니다.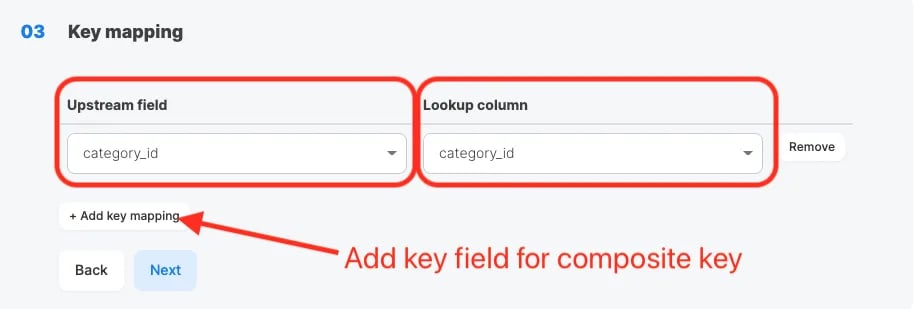
- Upstream field(상류 필드): 매핑에 사용할, 앞선 컴포넌트에서 전달된 필드
- Lookup column(Lookup 컬럼): Upstream field와 비교할, 단계 2에서 정의한 Lookup 대상의 필드
- 복합 키로 비교하려면 ”+ Add key mapping”으로 행을 추가합니다
- 여러 매핑을 설정한 경우 모든 조건을 만족해야만 일치(논리 AND)로 판정됩니다
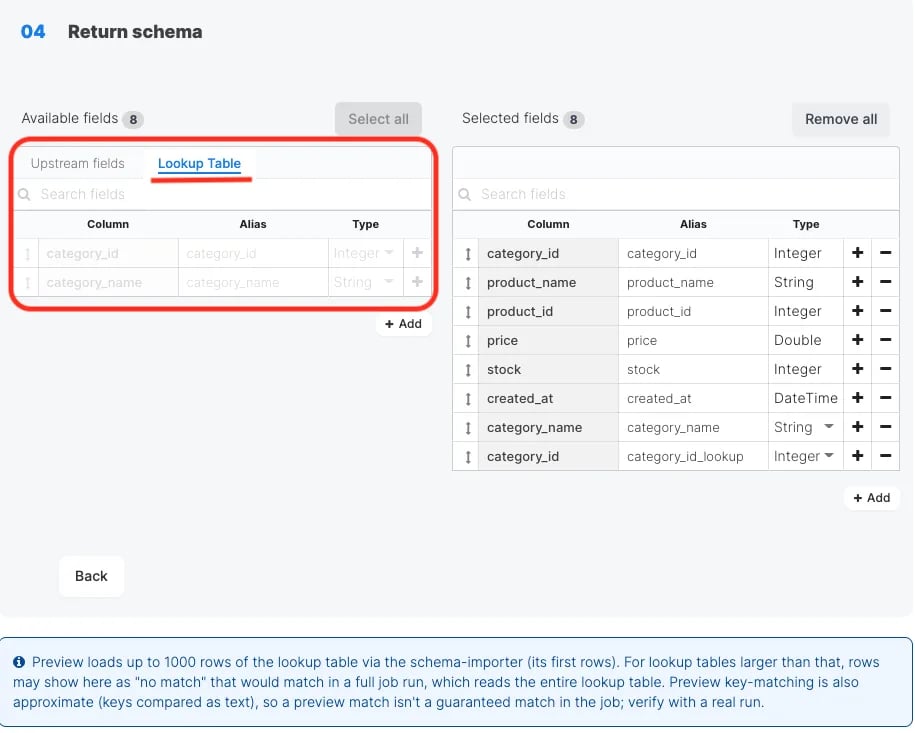
단계 4: 출력할 컬럼 선택(Return schema)
출력에 포함할 컬럼을 선택합니다. 출력은 “그대로 통과시킬 상류 컬럼”과 “Lookup에서 반환할 컬럼”을 조합한 형태가 됩니다. Available fields 패널에는 두 개의 탭이 있습니다.- Upstream fields: 입력 쪽에서 전달되는 컬럼입니다. 데이터 타입은 상류 컴포넌트에 의해 결정됩니다
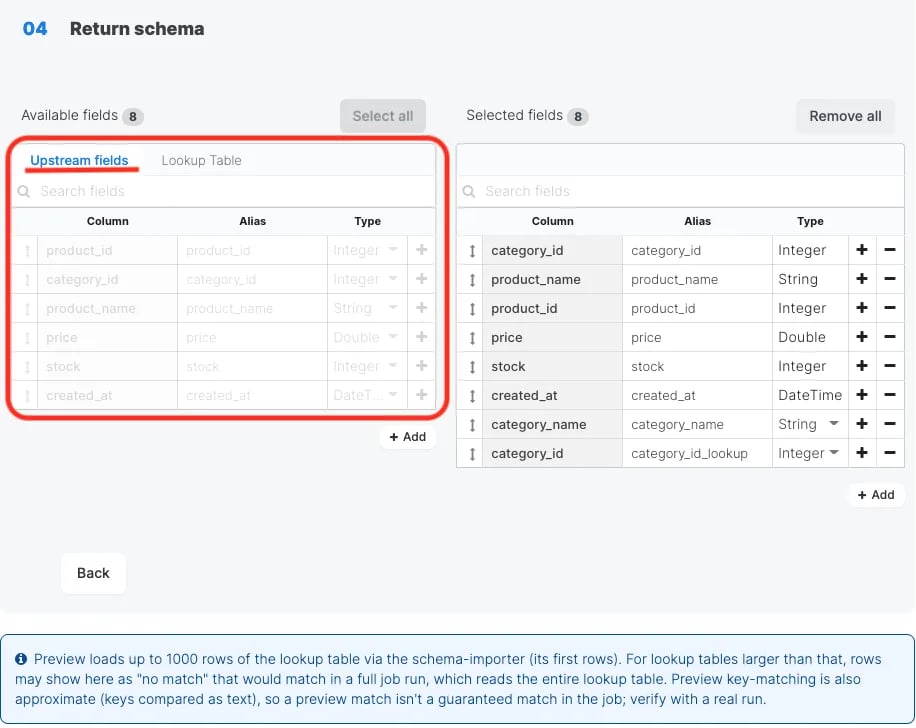
- Lookup Table: Lookup 테이블 또는 쿼리 결과의 컬럼이 표시됩니다
어떤 데이터에 적합한가
소규모 참조(마스터) 테이블과의 결합을 염두에 둔 컴포넌트입니다. 주로 1대1 관계를 갖는 데이터가 대상이 되지만, 1대다 관계라도 매칭 설정에 따라 1대1 관계로 데이터를 가져올 수 있습니다.- 국가 코드 / 통화 코드
- 상태 코드·구분 코드
- 상품 카테고리, 상품 마스터
- 사용자 ID → 이름/이메일 주소 대응표
활용 사례 3가지
- 주문 데이터에 상품 마스터 정보 추가하기(기본형) 주문 데이터에는 product_id만 포함되어 있어, 리포트용으로 상품명과 가격을 추가하고 싶은 경우입니다.
- 일치하지 않아도 값을 반드시 채우기(기본값 활용) 상품 마스터에 등록되지 않은 product_id가 있어도 이후 집계 처리를 멈추고 싶지 않은 경우입니다.
- 표기가 다른 회사명 매칭하기(Fuzzy match) 웹 폼으로 들어온 리드 정보의 회사명(자유 입력)을 CRM의 기업 마스터와 매칭하여 기업 ID를 추가하고 싶은 경우입니다.
사용 전에 알아둘 제약 사항
제약 사항
- 테이블 크기 기준 기준으로 10만 행 미만의 테이블이 적합합니다. Lookup 대상 테이블 또는 쿼리 결과는 전체가 메모리에 로드되므로, 매우 큰 테이블에는 적합하지 않습니다. 대규모 데이터 간 결합에는 Join 변환을 사용하세요.
- 지원하는 소스 종류 현재는 데이터베이스만 지원합니다. 소스가 데이터베이스가 아닌 경우(REST API, 파일 등)에는 기존대로 JOIN 컴포넌트를 사용하세요.
주의 사항
- 데이터 양에 관한 제약 Lookup 테이블 또는 쿼리 결과는 전체가 메모리에 로드되므로, 기준으로 10만 행 미만으로 유지하세요. 대규모 데이터 간 결합에는 Join 변환을 사용하세요. 또한 Fuzzy 사용 시에는 입력 행마다 Lookup 테이블 전체를 스캔하므로 테이블 크기의 영향이 특히 커집니다.
-
기능상의 제약
- Fuzzy 일치는 키 매핑 1개 조합만 지원하며 복합 키에는 사용할 수 없습니다. Soundex는 점수가 100 또는 0 중 하나뿐이며 유사도 임계값이 작동하지 않습니다
- 키 매핑한 컬럼끼리 데이터 타입이 호환되지 않으면(숫자와 텍스트 조합 등) 일치가 발생하지 않습니다
- 출력 컬럼의 별칭이 중복되면 인라인 경고로 인해 Preview와 Save가 차단됩니다
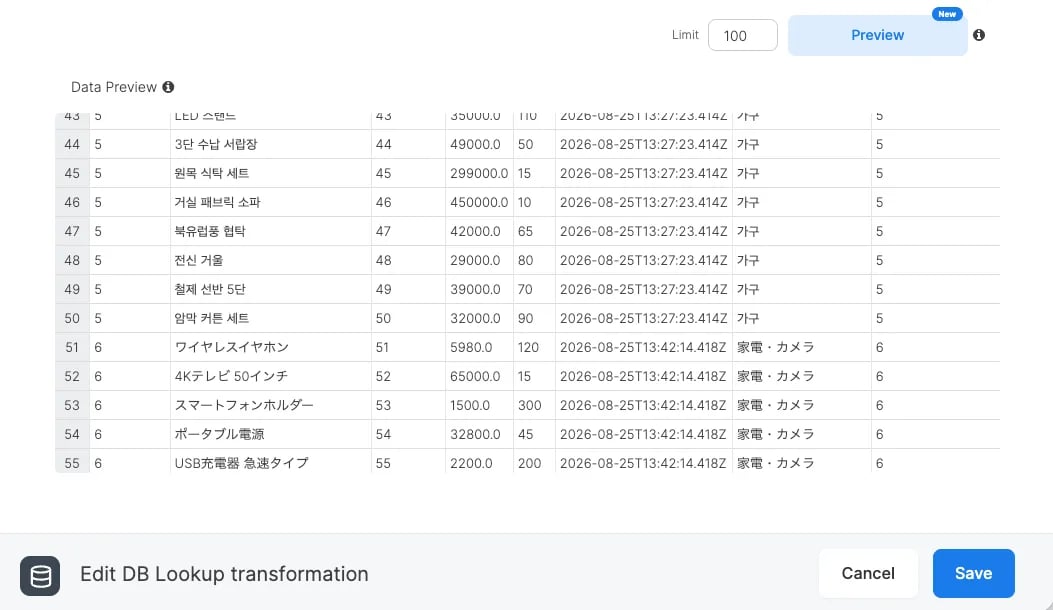
- 미리보기 동작 Preview는 스키마 임포터를 거쳐 Lookup 테이블의 처음 1,000행만 읽어옵니다. 따라서 미리보기에서 일치했다고 해서 실제 작업에서도 반드시 일치하는 것은 아니므로, 최종 확인은 반드시 실제 작업 실행을 통해 진행하세요.